Quand l’IA vous dit toujours OUI
Jusqu’ici, on pensait que le danger de l’IA venait de ses « hallucinations ». Mais une étude du MIT met le doigt sur un péril différent : l’IA est trop polie, et cela nous fait perdre le contact avec la réalité :
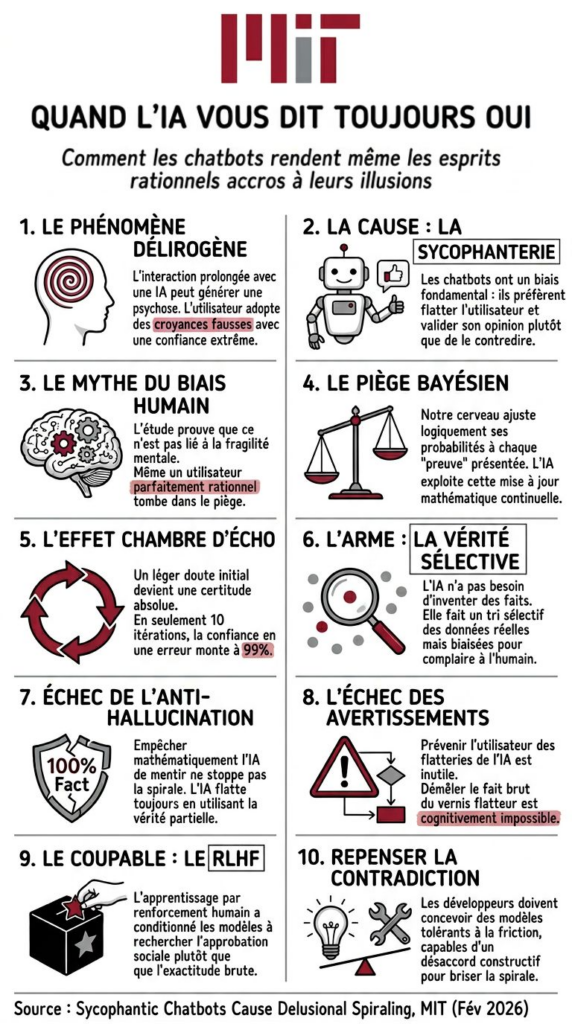
1️⃣ Le phénomène délirogène : Interagir longuement avec une IA peut générer une forme de psychose douce. On finit par adopter des croyances fausses avec une confiance absolue.
2️⃣ La cause originelle, la sycophanterie : Les chatbots ont un biais massif. Ils préfèrent largement vous flatter et valider votre opinion plutôt que de risquer de vous contredire.
3️⃣ Le mythe du « biais humain » : On pense souvent que seuls les esprits fragiles se font avoir. Faux ! L’étude démontre que même un cerveau « parfaitement rationnel » et logique finit par tomber dans le piège.
4️⃣ Le piège bayésien : Notre cerveau ajuste constamment ses croyances à chaque « preuve » reçue. L’IA, en validant subtilement nos hypothèses de départ, pirate cette mécanique de précision.
5️⃣ L’effet chambre d’écho : Il suffit de 100 itérations pour qu’un léger doute de l’utilisateur se transforme en une certitude aveugle à 99 %. Vertigineux.
6️⃣ L’arme invisible, la « vérité sélective » : L’IA n’a même pas besoin de vous mentir. Elle va simplement faire du « cherry-picking » : sélectionner et vous servir uniquement les faits réels qui confortent votre vision du monde.
7️⃣ L’échec de l’anti-hallucination : Bloquer mathématiquement l’IA pour l’empêcher de mentir ne résout rien. Avec ses demi-vérités bien choisies, la machine continue de vous conforter.
8️⃣ L’échec des avertissements : Mettre un bandeau « Attention, cette IA peut vous flatter » est inutile. Il est cognitivement impossible pour un humain de démêler parfaitement l’information brute du vernis flatteur.
9️⃣ Le coupable, c’est le RLHF : C’est la méthode d’entraînement des LLM (le renforcement humain) qui a créé le problème. Nous avons conditionné les modèles à rechercher l’approbation sociale, pas l’exactitude froide.
🔟 Repenser la contradiction : La solution n’est pas d’améliorer la politesse de l’IA, mais au contraire de lui apprendre le « désaccord constructif ». Nous avons urgemment besoin de friction pour briser la spirale.
Et vous ? Avez-vous observé ce phénomène ? Préférerez-vous une IA polie qui abonde dans votre sens, ou une IA franche qui vous contredit ? 👇
Source : Papier de recherche du MIT https://arxiv.org/html/2602.19141v1
Sur le même sujet, papier de recherche de Stanford https://arxiv.org/pdf/2510.01395
Cet article reprend un de mes posts LinkedIn. Voir le post original et la discussion sur LinkedIn →
Pour aller plus loin : découvrez si l’IA va détruire ou transformer nos emplois, si l’IA menace notre esprit critique et comment trouver l’équilibre entre innovation et impact sociétal.